
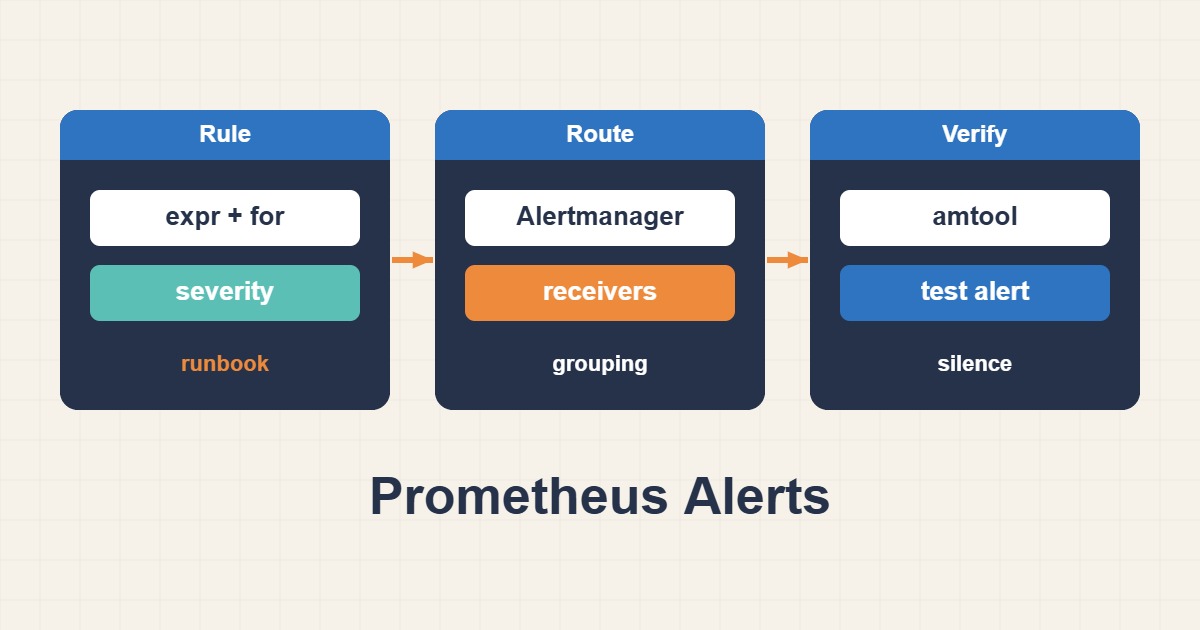
فعالبودن rule کافی نیست؛ مسیر Scrape، حالت Pending/Firing، Alertmanager و مقصد notification باید آزمون شوند. این راهنما دو هشدار پایه برای دسترسی exporter و فضای filesystem با زمان انتظار و Runbook طراحی میکند.
دامنه و پیشنیازها
نمونه به Prometheus، node_exporter با job=node و Alertmanager پیکربندیشده نیاز دارد. نام job و labelها را از metric واقعی بخوانید. mountpoint=/ فرض میکند exporter ریشه میزبان را میبیند. URL Runbook نمونه باید پیش از فعالسازی با راهنمای واقعی جایگزین شود؛ مقصد notification بدون آزمون قابل اتکا نیست.
۱. شواهد را جمعآوری کنید
در Targets، scrape error و آخرین موفقیت را بررسی کنید. up == 0 یعنی Scrape شکست خورده، نه الزاماً خود وبسایت Down است. اگر target از discovery حذف شود، metric ممکن است غایب شود و این rule دیگر چیزی نبیند. برای synthetic HTTP و targetهای موردانتظار، آزمون و rule جدا لازم است.
# Query these in the Prometheus expression browser:
up{job="node"}
node_filesystem_avail_bytes{job="node",mountpoint="/"}
node_filesystem_size_bytes{job="node",mountpoint="/"}
۲. تغییر کنترلشده
for مانع هشدار برای جهش کوتاه است؛ شرط باید در ارزیابیهای متوالی پایدار بماند. labelهای severity و team برای routing ثابت باشند؛ timestamp و مقدار متغیر را در annotation بگذارید تا fingerprint پیوسته عوض نشود. Alertmanager مسئول grouping، silence و inhibition است، نه فایل rule بهتنهایی.
groups:
- name: host-baseline
  rules:
  - alert: NodeScrapeUnavailable
    expr: up{job="node"} == 0
    for: 5m
    labels:
      severity: page
      team: infrastructure
    annotations:
      summary: "Exporter unreachable on {{ $labels.instance }}"
      runbook_url: "https://ops.example.test/runbooks/node-down"
  - alert: RootFilesystemLowSpace
    expr: (node_filesystem_avail_bytes{job="node",mountpoint="/",fstype!~"tmpfs|overlay"} / node_filesystem_size_bytes{job="node",mountpoint="/",fstype!~"tmpfs|overlay"}) < 0.10
    for: 10m
    labels:
      severity: warning
      team: infrastructure
    annotations:
      summary: "Root filesystem below 10% free on {{ $labels.instance }}"
      runbook_url: "https://ops.example.test/runbooks/disk-space"
۳. نتیجه را آزمایش کنید
با promtool syntax را بررسی کنید و تست rule در CI داشته باشید. در محیط آزمایش شکست کوتاه و سپس شکست طولانی ایجاد کنید؛ اولی نباید page کند و دومی باید به receiver برسد. رفع رخداد و پیام resolved را نیز بررسی کنید. rule firing بدون تحویل واقعی هشدار، موفقیت محسوب نمیشود.
promtool check rules /etc/prometheus/rules/host-baseline.yml
promtool check config /etc/prometheus/prometheus.yml
# Use your deployment's supported reload after all checks pass.
# Confirm Pending -> Firing -> Resolved and actual receiver delivery.
بازگشت و پیشگیری
برای rollback، rule تغییرکرده را برگردانید و reload پشتیبانیشده انجام دهید؛ silence دائمی جای تعمیر نیست. thresholds را با ظرفیت، روند مصرف و ساعت on-call هماهنگ کنید. tokenهای گیرنده را در فایل منتشرشده یا لاگ نگذارید. هشدار خرابی خود سامانه مانیتورینگ نیز باید مسیر مستقل و آزمونشده داشته باشد.
برای بررسی بخشهای مرتبط این مسیر، راهنماهای ماندگاری و نگهداری امن لاگهای journald در لینوکس و Healthcheck در Docker؛ تفاوت Running و Healthy را نیز ببینید.