
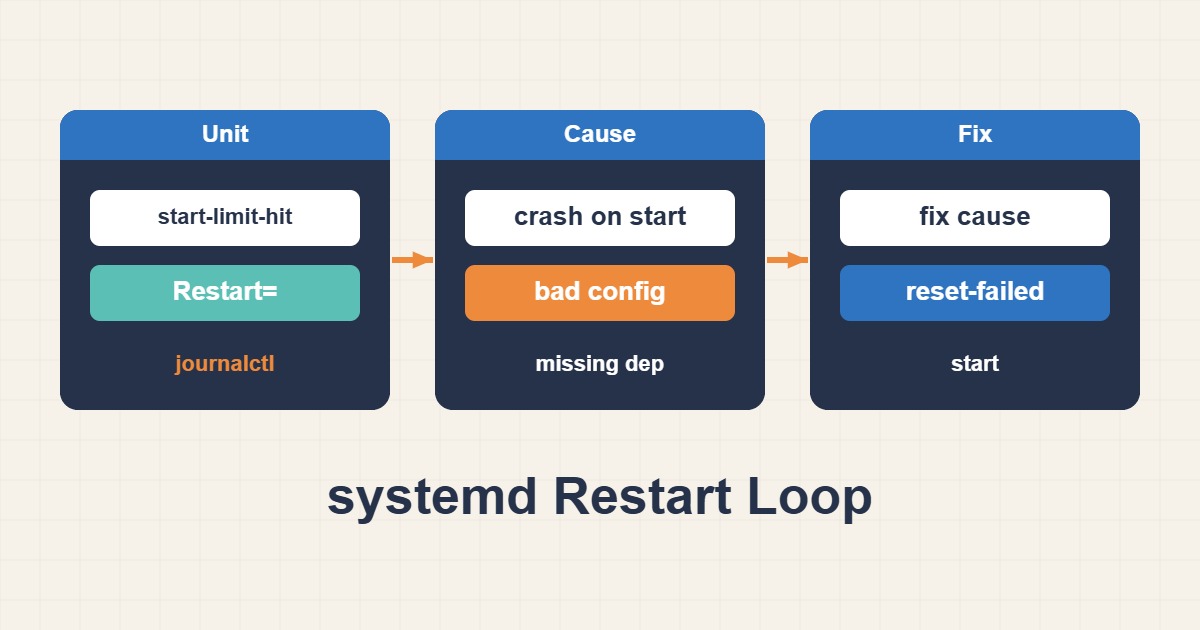
وقتی یک سرویس بلافاصله Crash میکند و systemd پیدرپی آن را Restart میکند، Start Limit برای جلوگیری از حلقه فعال میشود. reset-failed فقط شمارنده را پاک میکند؛ علت اصلی در Exit Code، Journal، وابستگی یا پیکربندی سرویس است.
وضعیت و Exit Code را ثبت کنید
سرویس را قبل از تغییر واحد دستی اجرا نکنید. ابتدا Result، ExecMainStatus و زمان Restartها را ببینید.
systemctl status myapp.service --no-pager -l
systemctl show myapp.service -p Result -p ExecMainStatus -p NRestarts
Journal را از اولین خطا بخوانید
آخرین خط همیشه علت اصلی نیست. لاگ Boot جاری و بازه قبل از Start Limit را بررسی کنید.
journalctl -u myapp.service -b --no-pager
journalctl -u myapp.service --since "30 min ago"
Unit و Overrideها را بررسی کنید
Restart=always میتواند خطای پیکربندی را به Loop تبدیل کند. Unit نهایی و Drop-inها را ببینید.
systemctl cat myapp.service
systemd-analyze verify /etc/systemd/system/myapp.service
پس از رفع علت Limit را Reset کنید
فقط بعد از اصلاح باینری، Permission، Environment یا Dependency از reset-failed استفاده کنید.
sudo systemctl daemon-reload
sudo systemctl reset-failed myapp.service
sudo systemctl start myapp.serviceچکلیست systemd
- Status و Exit Code را ثبت کنید.
- Journal Boot جاری را بخوانید.
- Unit و Drop-in را بررسی کنید.
- Dependency و Permission را تست کنید.
- پس از اصلاح reset-failed و Start کنید.
سؤالهای رایج
آیا reset-failed مشکل را حل میکند؟
خیر؛ فقط وضعیت Failed و شمارنده Rate Limit را پاک میکند.
چرا سرویس دستی اجرا میشود اما با systemd نه؟
Environment، WorkingDirectory، User، Permission و Path در Unit متفاوت است.
آیا Restart=always مناسب است؟
برای همه خطاها نه. on-failure همراه Delay و Start Limit معمولاً امنتر است.
راهنماهای مرتبط
منابع و مستندات رسمی
آخرین بررسی منابع: ۳۰ سپتامبر ۲۰۲۶