
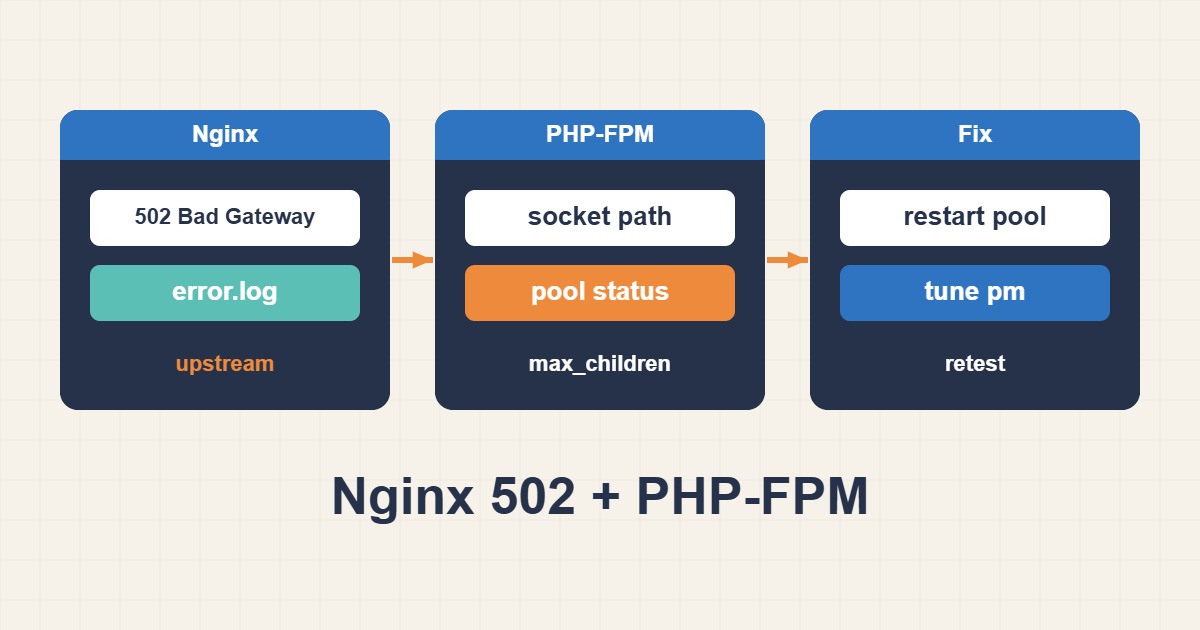
خطای 502 Bad Gateway در Nginx یعنی Nginx بهعنوان Reverse Proxy یا FastCGI Gateway نتوانسته پاسخ معتبر و کامل از Upstream دریافت کند. در سایتهای PHP، Upstream معمولاً PHP-FPM است. راهحل درست با خواندن لاگ و تشخیص نوع شکست شروع میشود، نه افزایش تصادفی Timeout.
۱. زمان و محدوده خطا را مشخص کنید
بررسی کنید خطا دائمی است یا در ساعات پرترافیک رخ میدهد، همه URLها را درگیر میکند یا فقط یک Endpoint، و آیا پس از Deploy، تغییر PHP یا Restart ایجاد شده است. زمان دقیق خطا را با Access Log و Error Log تطبیق دهید.
۲. لاگ Nginx و PHP-FPM را بخوانید
tail -n 100 /var/log/nginx/error.log
journalctl -u php-fpm --since "10 minutes ago"
systemctl status nginx php-fpmپیامهایی مانند connect() failed، Connection refused، No such file or directory، upstream timed out یا upstream prematurely closed connection مسیر عیبیابی متفاوتی دارند.
۳. Socket یا پورت FastCGI را تطبیق دهید
مقدار fastcgi_pass در Nginx باید دقیقاً با listen در Pool مربوط به PHP-FPM یکسان باشد. پس از تغییر نسخه PHP، ممکن است Nginx هنوز به Socket نسخه قبلی اشاره کند.
grep -R "fastcgi_pass" /etc/nginx
grep -R "^listen" /etc/php*/fpm/pool.d /etc/php-fpm.d
ss -lntp | grep php
برای Unix Socket، وجود فایل، مالکیت و Permission آن را بررسی کنید. تنظیمات listen.owner، listen.group و listen.mode باید با کاربر Nginx سازگار باشد.
۴. سلامت PHP-FPM و Workerها را بررسی کنید
اگر سرویس متوقف یا Crash شده، علت را در Journal و PHP Log پیدا کنید. به pm.max_children، تعداد Workerهای Busy، صف Listen، Memory هر Worker و پیام server reached pm.max_children توجه کنید. افزایش Worker بدون RAM کافی باعث OOM و Crash بیشتر میشود.
۵. Slow Script و Timeout را تشخیص دهید
upstream timed out میتواند از Query کند، API خارجی، Lock، فایل بزرگ یا PHP طولانی باشد. قبل از افزایش fastcgi_read_timeout، Slow Log PHP-FPM و زمان پاسخ Endpoint را بررسی کنید.
request_slowlog_timeout = 5s
slowlog = /var/log/php-fpm/slow.log
request_terminate_timeout = 120s
Timeoutهای Nginx، PHP-FPM و PHP باید آگاهانه هماهنگ باشند. Timeout بسیار بالا میتواند Workerهای گیرکرده را برای مدت طولانی اشغال کند.
۶. منابع سرور را بررسی کنید
free -m
df -h
df -i
uptime
journalctl -k | grep -i -E 'oom|killed process'
پرشدن دیسک یا inode، کمبود RAM، OOM Killer و محدودیت Process میتواند Upstream را از دسترس خارج کند. فقط Restart کردن بدون رفع فشار منابع راهحل پایدار نیست.
اگر در Kernel Log پیامهای Out of memory یا Killed process مشاهده میشود، راهنمای رفع مصرف بالای RAM و خطای OOM Killer در لینوکس را برای بررسی Memory Pressure، Swap و نشت حافظه دنبال کنید.
۷. پیکربندی Nginx را اعتبارسنجی کنید
nginx -t
systemctl reload nginx
قبل از Reload همیشه Syntax Test بگیرید. Includeها، Server Block صحیح، پارامترهای FastCGI و مقدار SCRIPT_FILENAME را بررسی کنید. مسیر اشتباه فایل یا Root میتواند رفتار نامعتبر ایجاد کند.
۸. ارتباط با Container یا Reverse Proxy
در Docker یا Kubernetes، نام سرویس، DNS داخلی، پورت، Health Check، Restart Count و Network Policy را بررسی کنید. اگر IP Container تغییر میکند، از Service Discovery استفاده کنید و IP موقت را در تنظیمات ثابت نکنید.
۹. اقدام فوری و امن
در Incident فعال، در صورت تأیید میتوانید PHP-FPM را کنترلشده Restart کنید، ترافیک مخرب را محدود کنید یا نسخه سالم را Rollback کنید. قبل از اقدام، لاگ و Metric را ذخیره کنید. از Reload یا Restart پشتسرهم بدون مشاهده وضعیت خودداری کنید.
اگر خطای 502 همزمان با افزایش ناگهانی درخواستهای Login یا API رخ میدهد، راهنمای تنظیم Rate Limit در Nginx برای Login و API را برای کنترل ترافیک پرتکرار پیش از رسیدن آن به PHP-FPM بررسی کنید.
۱۰. تأیید نهایی
پس از اصلاح، چند صفحه PHP، ورود، فرم، آپلود، REST API و عملیات دیتابیس را تست کنید. Error Rate، Latency، تعداد Worker Busy، Queue و Memory را پایش کنید. پاسخ 200 یک درخواست بهتنهایی کافی نیست؛ خطا باید در بازه پرترافیک نیز برنگردد.
چکلیست پیشگیری
- Status Page و Slow Log برای PHP-FPM فعال کنید.
- برای Worker، RAM و ترافیک Capacity Planning داشته باشید.
- نسخه PHP و Socket را در Deploy بررسی خودکار کنید.
- Config Test را قبل از Reload اجباری کنید.
- روی 502، Queue و OOM هشدار مانیتورینگ بسازید.
منابع و مستندات رسمی
آخرین بررسی منابع: ۳۰ سپتامبر ۲۰۲۶