
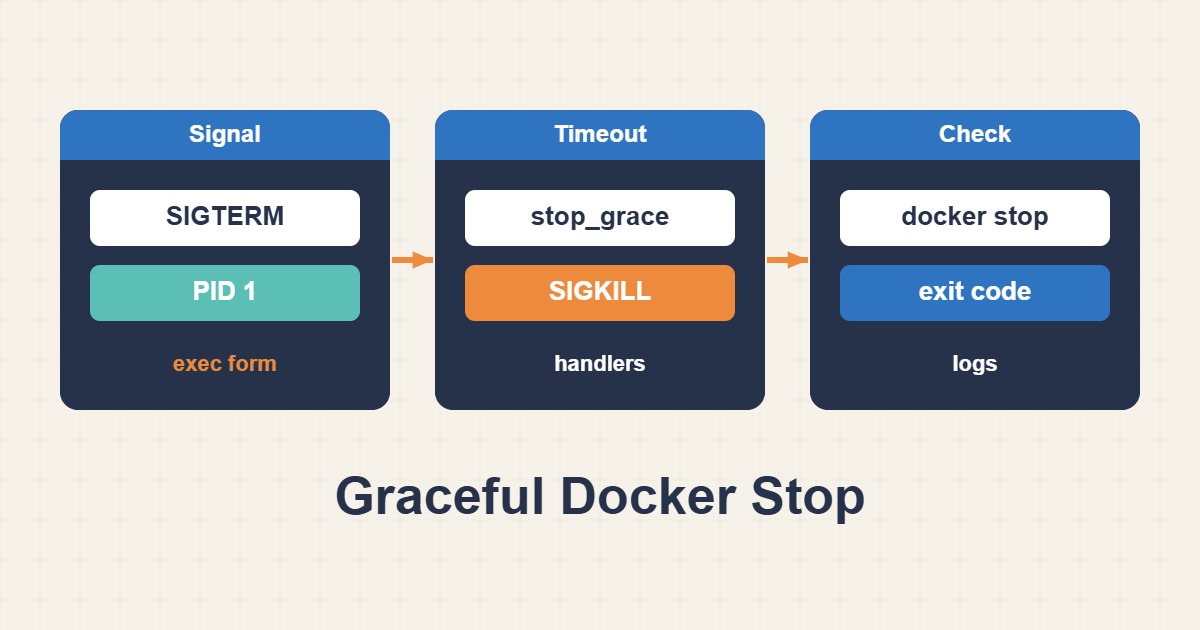
وقتی Deploy انجام میشود، سالمبودن Healthcheck قبل از توقف کافی نیست. برنامه باید درخواست جدید را کنار بگذارد، کار جاری را به وضعیت مشخص برساند و منابع را ببندد. این راهنما تفاوت توقف عادی و اجباری Docker را بررسی میکند و نشان میدهد چرا زیادکردن timeout، بدون مدیریت سیگنال در برنامه، تضمینکننده سلامت داده نیست.
دامنه آزمون و رفتار پیشفرض
آزمون توقف را ابتدا روی Staging یا در پنجره نگهداری اجرا کنید؛ دستور stop سرویس را قطع میکند. نام r89-api و image نمونه را با سرویس آزمایشی جایگزین کنید. این مقاله سیاست shutdown برنامه را توضیح میدهد، نه توصیه به توقف کانتینرهای دیتابیس تولید بدون Runbook.
Docker به پردازه اصلی کانتینر ابتدا SIGTERM میفرستد، مگر StopSignal سفارشی تنظیم شده باشد. پس از پایان مهلت، اگر پردازه خارج نشده باشد SIGKILL ارسال میشود. پیشفرض معمول Linux ده ثانیه و Windows سی ثانیه است، اما پیکربندی کانتینر و گزینه timeout میتواند آن را تغییر دهد.
۱. پردازه اصلی و زمانبندی را ثبت کنید
فرمان شروع، StopSignal، Restart Policy و رویدادهای توقف را ثبت کنید. لاگ را با زمان رویداد stop/kill/die تطبیق دهید. برای تصویرهای کوچک یا distroless، نبود sh یا ps طبیعی است؛ برای مشاهده پردازهها میتوان از docker top روی میزبان استفاده کرد.
خروج با کد 137 اغلب با SIGKILL مرتبط است، اما بهتنهایی ثابت نمیکند timeout علت بوده؛ OOM یا kill بیرونی نیز ممکن است. OOMKilled، لاگ هسته و رویدادهای Docker را کنار هم بخوانید. محتویات کامل inspect میتواند متغیرهای محیطی حساس داشته باشد؛ خروجی را محدود کنید.
docker inspect --format 'StopSignal={{.Config.StopSignal}} Restart={{.HostConfig.RestartPolicy.Name}}' r89-api
docker top r89-api
docker logs --since 10m --tail 200 r89-api
docker events --since 10m --until "$(date -Iseconds)" --filter container=r89-api
۲. سیگنال را به برنامه برسانید
در Dockerfile، فرم exec مانند ENTRYPOINT ["node", "server.js"] کمک میکند برنامه پشت shell بیمسئولیت پنهان نشود. اگر startup script دارید، آخر آن از exec برای اجرای برنامه استفاده کنید یا مدیریت و انتقال سیگنال را صریح پیاده کنید. فقط عوضکردن CMD تضمین نمیکند ENTRYPOINT موجود درست رفتار کند.
در Compose، init: true یک init کوچک برای انتقال سیگنال و جمعآوری پردازههای فرزند اضافه میکند، اما نمیتواند منطق cleanup برنامه را بسازد. خود برنامه باید SIGTERM را مدیریت کند: کار جدید نپذیرد، اتصالها را drain کند و کار جاری را با timeout داخلی محدود به پایان برساند.
۳. مهلت توقف را بر اساس کار واقعی تنظیم کنید
نمونه Compose زیر فقط الگوی تنظیم است و فایل کامل پروژه نیست. مقدار 30s توصیه عمومی نیست؛ مدت درخواست، تراکنش، job و مهلت Load Balancer را اندازه بگیرید. مهلت برنامه باید پیش از پایان فرصت کانتینر تمام شود و سیاست retry برای کار نیمهتمام مشخص باشد.
تغییر Compose باید validate و با Deploy برنامهریزیشده اعمال شود؛ restart ساده الزاماً تنظیم جدید ساخت کانتینر را اعمال نمیکند. رفتار StopSignal سفارشی را با مستندات image تطبیق دهید. SIGKILL قابل گرفتن برای cleanup نیست و timeout نامحدود هم میتواند Deploy را متوقف نگه دارد.
# Compose fragment: use your real, tested application image.
services:
  api:
    image: registry.example.com/team/api:tested-tag
    init: true
    stop_signal: SIGTERM
    stop_grace_period: 30s

# Validate the merged project before a planned deployment.
# docker compose config --quiet
آزمون پذیرش و بازگشت
در محیط آزمایشی، یک درخواست کوتاه و یک job طولانی کنترلشده اجرا کنید و توقف را آغاز کنید. لاگ باید ورود به shutdown و پایان cleanup را نشان دهد. سپس وضعیت نهایی داده، acknowledgement صف و امکان شروع دوباره سرویس را بررسی کنید؛ نبود خطا در لاگ کافی نیست.
اگر زمانبندی یا منطق cleanup مشکل دارد، تنظیم قبلی و image قبلی را در همان چرخه Deploy برگردانید؛ timeout را صرفاً بیشتر نکنید. مدت shutdown، شمار کارهای ناتمام و دفعات kill اجباری را پایش کنید. از آزمون توقف مکرر روی داده واقعی بدون Backup و Runbook پرهیز کنید.
# Test environment only: this stops the named service.
docker stop --timeout 30 r89-api
docker inspect --format 'Status={{.State.Status}} Exit={{.State.ExitCode}} OOMKilled={{.State.OOMKilled}}' r89-api
مطالعه مرتبط
- Healthcheck در Docker؛ تفاوت Running و Healthy
- عیبیابی DNS و ارتباط سرویسها در شبکه Docker
- جلوگیری از پرشدن دیسک با چرخش لاگ Docker