
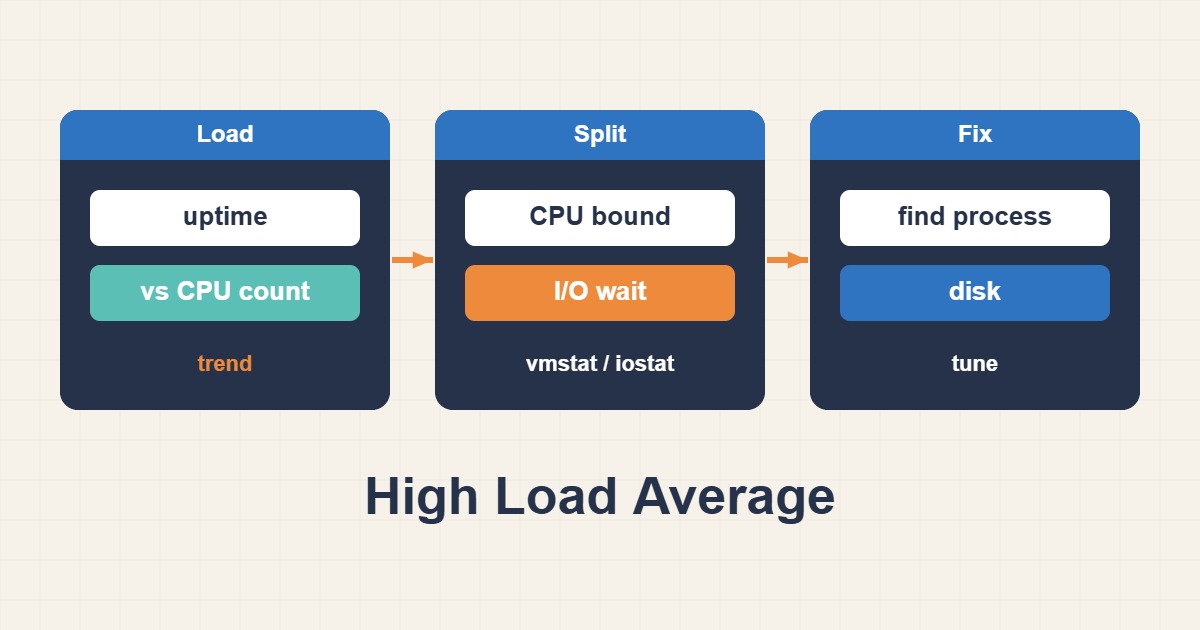
بالا رفتن Load Average همیشه به معنی کمبود CPU نیست. در لینوکس، پردازشهایی که آماده اجرا هستند و پردازشهایی که در وضعیت D منتظر I/O ماندهاند هر دو روی Load اثر میگذارند. به همین دلیل ممکن است Load بالا باشد، اما CPU هنوز زمان بیکار داشته باشد. راه درست این است که ابتدا نوع فشار را مشخص کنیم و بعد سراغ دیسک، پردازش یا سرویس مقصر برویم.
Load Average را با تعداد هستهها و زمان مقایسه کنید
خروجی uptime میانگین یک، پنج و پانزده دقیقه را نشان میدهد. عدد 8 روی سرور 16 هستهای الزاماً بحران نیست؛ همان عدد روی ماشین 2 هستهای هشدار جدی است. روند مهمتر از یک نمونه است: اگر مقدار یکدقیقهای بالا و مقدار پانزدهدقیقهای پایین باشد، احتمالاً با یک جهش تازه روبهرو هستید.
nproc
uptime
cat /proc/loadavg
فشار CPU را از انتظار I/O جدا کنید
با vmstat 1 ستونهای r، b و wa را کنار هم ببینید. صف r بزرگ و CPU نزدیک به اشباع معمولاً فشار پردازشی است. افزایش b و wa همراه با CPU نسبتاً بیکار بیشتر به انتظار دیسک یا storage اشاره میکند.
vmstat 1
mpstat -P ALL 1
pidstat -u -d 1
دیسک کند یا صف عمیق را پیدا کنید
iostat -xz 1 را چند نمونه اجرا کنید، نه فقط یکبار. به latency خواندن و نوشتن، طول صف و درصد مشغولبودن دستگاه توجه کنید. اشباع یک volume ممکن است از backup، log rotation، query سنگین، swap یا storage اشتراکی ناشی شود. در VM نیز %steal بالا میتواند نشانه رقابت روی میزبان باشد.
iostat -xz 1
iotop -oPa
lsblk -o NAME,FSTYPE,SIZE,MOUNTPOINTS
از PSI برای دیدن اثر واقعی فشار استفاده کنید
روی کرنلهای جدید، فایلهای /proc/pressure/cpu، memory و io نشان میدهند workload چه مقدار از زمان را بهدلیل کمبود منبع متوقف بوده است. مقدار full در فشار I/O یا memory مهم است، چون یعنی همه کارهای غیر idle همزمان متوقف شدهاند.
for f in /proc/pressure/{cpu,memory,io}; do echo ===$f; cat $f; doneقبل از هر تغییر، پردازش و زمان رخداد را ثبت کنید
کشتن سریع پردازش ممکن است علامت را پاک کند و علت اصلی باقی بماند. PID، command، زمان شروع، فایلهای باز و همزمانی با cron، backup یا deploy را ثبت کنید. سپس اقدام متناسب انجام دهید: بهینهسازی query، محدودکردن concurrency، انتقال job سنگین، افزایش IOPS یا اصلاح retention لاگ.
چکلیست سریع
- Load را نسبت به تعداد CPU و روند ۱/۵/۱۵ دقیقه بررسی کنید.
- با vmstat مشخص کنید صف runnable است یا blocked.
- با iostat و pidstat دستگاه و پردازش مقصر را پیدا کنید.
- فشار memory، swap و PSI را همزمان ببینید.
- قبل از restart یا kill، شواهد و زمان رخداد را ذخیره کنید.
سؤالهای رایج
آیا Load Average بالا همیشه خطرناک است؟
خیر. باید آن را با تعداد هستهها، latency سرویس و نوع workload مقایسه کرد. Load کوتاهمدت در زمان backup ممکن است قابل قبول باشد، اما رشد پایدار همراه با کندی سرویس نیاز به اقدام دارد.
آیا %util برابر 100 همیشه یعنی دیسک خراب است؟
نه. روی بعضی deviceها و storageهای موازی، %util بهتنهایی کافی نیست. latency، queue depth، throughput و محدودیتهای storage provider را هم بررسی کنید.
اولین دستور برای شروع چیست؟
برای یک تصویر سریع، uptime، vmstat 1 و iostat -xz 1 را کنار هم اجرا کنید؛ سپس با pidstat یا iotop سراغ پردازش مقصر بروید.
راهنماهای مرتبط
منبع فنی: مستندات Linux Kernel درباره PSI و آمار I/O، و راهنمای proc_loadavg.