
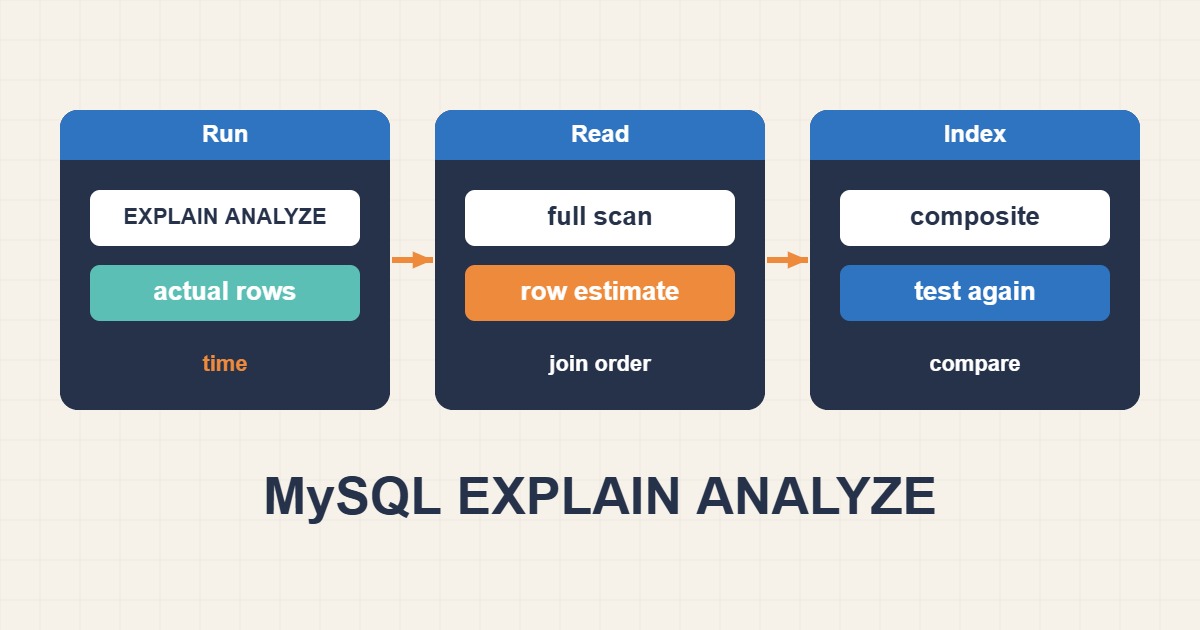
EXPLAIN مسیر تخمینی و EXPLAIN ANALYZE اجرای واقعی را نشان میدهد. این راهنما روی یک Query خواندنی نمونه، اختلاف estimate و actual، تعداد loop و انتخاب ایندکس مرکب را بررسی میکند.
دامنه و پیشنیازها
هدف MySQL 8.x با پشتیبانی EXPLAIN ANALYZE است؛ رفتار MariaDB یکسان فرض نشود. نام orders و ستونها آموزشیاند. روی Replica یا staging نماینده شروع کنید؛ EXPLAIN ANALYZE واقعاً اجرا میکند و برای دستور نوشتن یا Query سنگین تولیدی خطر دارد. سقف زمان جلسه و امکان KILL QUERY را آماده کنید.
۱. شواهد را جمعآوری کنید
Query و پارامتر واقعی، cardinality و ایندکسهای موجود را ثبت کنید. در TREE، actual time بر حسب میلیثانیه است و در چند loop میانگین هر loop گزارش میشود. زمان parent معمولاً کار child را شامل میشود؛ جمعکردن تمام زمانها هزینه را دوباره میشمارد. mismatch بزرگ rows نشانه بررسی آمار یا skew داده است.
SHOW INDEX FROM orders;
EXPLAIN FORMAT=TREE
SELECT id, created_at FROM orders
WHERE customer_id=42 ORDER BY created_at DESC LIMIT 20;
۲. تغییر کنترلشده
برای فیلتر customer_id و مرتبسازی created_at، ایندکس مرکب زیر کاندید منطقی است، نه نتیجه تضمینی. پیش از DDL، فضای دیسک، metadata lock، هزینه نوشتن و روش online همان نسخه را بررسی کنید. ایندکس تکراری نسازید؛ ترتیب ستونها باید از الگوی equality، range و sorting واقعی پیروی کند.
-- Staging example: inspect existing indexes before DDL.
CREATE INDEX ix_orders_customer_created ON orders(customer_id, created_at);
۳. نتیجه را آزمایش کنید
طرح جدید را با همان داده و پارامتر مقایسه کنید. rows کمتر بدون latency بهتر کافی نیست؛ cold/warm cache و concurrency اثر دارند. نتایج Query باید ثابت بماند. scan کامل روی جدول کوچک الزاماً بد نیست و وجود نام ایندکس در plan نیز بهتنهایی موفقیت محسوب نمیشود.
SET SESSION max_execution_time=5000;
EXPLAIN ANALYZE FORMAT=TREE
SELECT id, created_at FROM orders
WHERE customer_id=42 ORDER BY created_at DESC LIMIT 20;
بازگشت و پیشگیری
اگر ایندکس جدید بار نوشتن یا replication lag ایجاد کرد، حذف همان ایندکس را در پنجره کنترلشده برنامهریزی کنید. تغییرهای schema هم نیاز به rollback و آزمون دارند. برای پیشگیری، latency و rows examined را برحسب digest Query پایش کنید؛ افزایش RAM یا ایندکسگذاری تمام ستونها جای خواندن plan نیست.
برای بررسی بخشهای مرتبط این مسیر، راهنماهای بازیابی نقطهای MySQL با Binlog؛ توقف پیش از حذف اشتباه و انتخاب سیاست Eviction و maxmemory در Redis را نیز ببینید.