
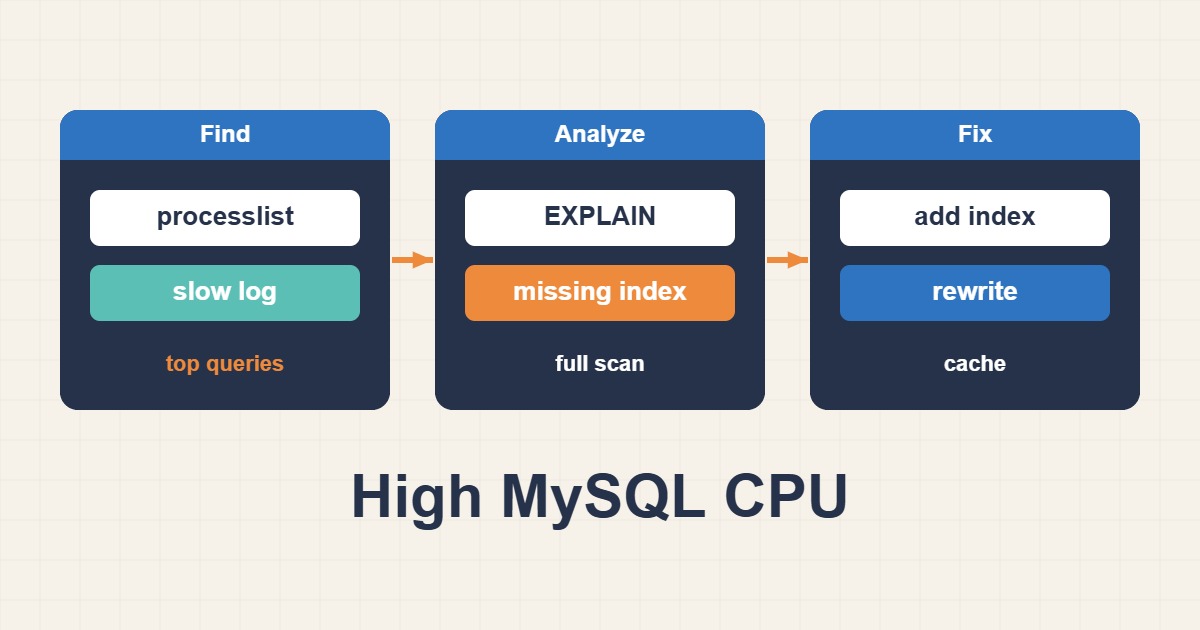
مصرف بالای CPU در MySQL معمولاً نتیجه یک Query پرهزینه، Index نامناسب، افزایش همزمانی، Lock، اسکن کامل جدول یا تغییر الگوی ترافیک است. افزایش vCPU ممکن است زمان بخرد، اما بدون شناسایی Query و علت اصلی، مشکل دوباره برمیگردد.
۱. ابتدا ثابت کنید CPU متعلق به MySQL است
top -p $(pidof mysqld)
pidstat -p $(pidof mysqld) 1
vmstat 1 10
iostat -xz 1 10
CPU را از I/O wait، Swap و Steal تفکیک کنید. اگر iowait بالا است، فقط Query CPU-bound ندارید و باید Storage و الگوی دسترسی بررسی شود.
۲. وضعیت لحظهای Connection و Queryها
SHOW FULL PROCESSLIST;
SHOW GLOBAL STATUS LIKE 'Threads%';
SHOW GLOBAL STATUS LIKE 'Questions';
SHOW GLOBAL STATUS LIKE 'Slow_queries';
Queryهای Running طولانی، تعداد Connection زیاد، Stateهای Waiting و الگوهای تکراری را ثبت کنید. Process را بدون شناخت Transaction و اثر آن Kill نکنید.
۳. Slow Query Log را هدفمند فعال کنید
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = 'ON';فعالسازی باید با مسیر Log، فضای دیسک و سیاست Rotation هماهنگ باشد. گزینه ثبت Query بدون Index میتواند حجم زیادی تولید کند؛ آن را موقت و کنترلشده استفاده کنید.
۴. Queryهای پرتکرار را تجمیع کنید
فقط کندترین Query مهم نیست. Query با زمان متوسط کم اما اجرای بسیار زیاد میتواند بیشترین CPU کل را مصرف کند. از ابزارهایی مانند pt-query-digest یا Performance Schema برای دستهبندی بر اساس Digest استفاده کنید.
۵. EXPLAIN را درست تفسیر کنید
EXPLAIN FORMAT=JSON SELECT ...;
EXPLAIN ANALYZE SELECT ...;
نوع Access، تعداد Row تخمینی و واقعی، Key انتخابشده، Temporary Table، Filesort و Join Order را بررسی کنید. EXPLAIN ANALYZE Query را اجرا میکند؛ روی Production و Queryهای تغییردهنده با احتیاط استفاده کنید.
۶. Index مناسب طراحی کنید
Index باید با ستونهای WHERE، JOIN، ORDER BY و الگوی انتخاب داده هماهنگ باشد. Index تکستونه همیشه جای Index مرکب را نمیگیرد. ترتیب ستونهای Index مرکب مهم است. قبل از افزودن Index، Cardinality، حجم نوشتن و Indexهای مشابه را بررسی کنید.
Index اضافی هزینه INSERT/UPDATE و فضای Buffer Pool را زیاد میکند. بعد از افزودن Index، Plan و زمان واقعی را دوباره اندازهگیری کنید.
۷. Performance Schema را بررسی کنید
SELECT DIGEST_TEXT, COUNT_STAR, SUM_TIMER_WAIT
FROM performance_schema.events_statements_summary_by_digest
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 10;
این گزارش Queryهایی را نشان میدهد که مجموع زمان زیادی مصرف کردهاند. همچنین Wait Eventها، Lockها و File I/O را بررسی کنید تا CPU از انتظار منابع تفکیک شود.
۸. Lock و Transaction طولانی
Transaction باز طولانی میتواند Purge، Lock و حجم Undo را تحت تأثیر قرار دهد. وضعیت InnoDB و Transactionها را بررسی کنید:
SHOW ENGINE INNODB STATUS;
SELECT * FROM information_schema.innodb_trx;
قبل از Kill کردن Session، اثر Rollback و عملیات برنامه را بسنجید.
۹. Buffer Pool، حافظه و Connectionها
اندازه InnoDB Buffer Pool باید با RAM، اندازه Working Set و سایر سرویسها متناسب باشد. Buffer Pool بسیار کوچک I/O را بالا میبرد و مقدار بسیار بزرگ میتواند سیستم را وارد Swap کند. Connection Limit، Thread Cache و Connection Pool برنامه را نیز بررسی کنید.
۱۰. تغییرات برنامه و ترافیک
زمان افزایش CPU را با Release، Migration، Import، Cron، Report، Bot و Endpointهای جدید مقایسه کنید. مشکل ممکن است از N+1 Query، Pagination نامناسب، جستوجوی بدون محدودیت یا Cache Miss گسترده ایجاد شده باشد.
۱۱. اقدام اصلاحی
- Query و Digest پرمصرف را مشخص کنید.
- Plan واقعی و تعداد Row را بررسی کنید.
- Query، Index یا الگوی دسترسی را در Staging اصلاح کنید.
- تغییر را با Metric قبل و بعد Deploy کنید.
- در صورت نیاز Rate Limit، Cache یا Queue اضافه کنید.
- افزایش منابع را فقط پس از بهینهسازی و با Capacity Plan انجام دهید.
۱۲. تأیید نهایی
CPU، Query Latency، Throughput، Slow Query Count، Rows Examined، Lock Wait، Buffer Pool Hit Rate و Error Rate برنامه را بررسی کنید. یک Query سریعتر کافی نیست؛ اثر تغییر بر نوشتن، Replication و سایر Queryها نیز باید سنجیده شود.
پیشگیری
- Slow Query Log و Performance Schema را با نگهداری مناسب استفاده کنید.
- برای Migration و Queryهای جدید Review و تست Plan داشته باشید.
- روی CPU، Latency، Connection، Lock و Replication Lag هشدار بسازید.
- Queryهای پرتکرار را بهصورت دورهای بازبینی کنید.
- رشد داده و تغییر Cardinality را در Capacity Planning لحاظ کنید.
منابع و مستندات رسمی
آخرین بررسی منابع: ۳۰ سپتامبر ۲۰۲۶